


Un LLM, o large language model (in italiano modello linguistico di grandi dimensioni), è un modello di intelligenza artificiale addestrato su enormi quantità di testo per prevedere il pezzo di testo che segue una sequenza.
Per funzionare, un modello linguistico stima la probabilità che un token, o una sequenza di token, compaia in un testo più lungo (Google, Machine Learning Crash Course). Non consulta, quindi, un archivio di fatti, ma si limita (per così dire) a produrre il testo più plausibile. Questa guida spiega che cos’è, come funziona, come si addestra, dove sbaglia e che cosa cambia per chi ha un marchio da difendere.
LLM: significato e che cosa lo rende “grande”
Il termine più importante in Large language models è sicuramente language, in quanto descrive appieno il modo in cui il modello lavora su sequenze di testo. Large indica invece che la sua capacità dipende da quanti dati vede in addestramento e da quanti parametri contiene. I parametri sono i valori numerici che il modello regola durante l’addestramento: GPT-3, descritto nel 2020 da Tom Brown e colleghi, ne contava 175 miliardi, dieci volte più di qualunque modello linguistico non sparso precedente (Brown et al., Language Models are Few-Shot Learners).
Il pezzo di testo su cui lavora il modello si chiama token: può essere una parola, una parte di parola o un singolo carattere, e la maggior parte dei modelli attuali usa parti di parola (Google, Machine Learning Crash Course). Per l’inglese, un token vale in media circa quattro caratteri, tre quarti di una parola.
Conviene tenere distinte quattro cose che nel linguaggio comune si confondono. Il modello è il motore, cioè l’LLM. L’applicazione è ciò che lo rende utilizzabile da una persona, come un assistente a cui si scrive una domanda. Questa distinzione aiuta anche a leggere strumenti come ChatGPT, Gemini e Claude: l’applicazione con cui interagisce l’utente può utilizzare modelli diversi e cambiarli nel tempo.
Il sistema è l’insieme di modello, istruzioni, dati e controlli attorno a cui si costruisce un servizio. L’agente è un software che interpreta una richiesta e agisce per eseguirla, spesso appoggiandosi a un LLM; come abbiamo già spiegato parlando di AI agent.
Modello, applicazione, sistema, agente
Quattro parole che nel linguaggio comune si confondono.
| Termine | Che cos’è | Esempio di ruolo |
|---|---|---|
| Modello (LLM) | Il motore: genera testo prevedendo il token successivo | Il componente che produce le risposte |
| Applicazione | Ciò che rende il modello utilizzabile da una persona | L’assistente a cui si scrive una domanda |
| Sistema | Modello, istruzioni, dati e controlli messi insieme per un servizio | Un servizio aziendale costruito su un modello |
| Agente | Software che interpreta una richiesta e agisce per eseguirla, spesso con un LLM | Chi esegue una sequenza di azioni dopo un’istruzione |
Sintesi di Bliss. Per l’agente: Bliss, Cos’è un AI agent e perché è essenziale per le PMI.
Come funziona un LLM
Un LLM genera testo con un ciclo che si ripete. Prende il testo che gli viene dato e lo divide in token. Calcola, per ogni token possibile, quanto è probabile che sia il prossimo. Ne sceglie uno. Lo aggiunge al testo e ricomincia, finché la risposta è completa.
- Il testo di partenza, la domanda o l’istruzione, viene scomposto in token.
- Il modello valuta il contesto e assegna a ogni token possibile una probabilità di essere il prossimo.
- Viene scelto un token in base a quelle probabilità.
- Il token scelto si aggiunge al testo e il ciclo riparte dal punto 2, fino alla fine della risposta.
Il punto 2 è quello che ha cambiato il settore. Fino al 2017 i modelli di traduzione e di linguaggio più diffusi erano basati su reti ricorrenti o convoluzionali. In quell’anno Ashish Vaswani e colleghi presentarono il Transformer, un’architettura che si regge solo sul meccanismo dell’attenzione e rinuncia a ricorrenza e convoluzioni (Vaswani et al., Attention Is All You Need). Il vantaggio pratico, che Google descrive nel suo corso, è che un modello di questo tipo valuta l’intero contesto in una volta, mentre le reti ricorrenti elaborano i token uno alla volta e faticano sulle sequenze lunghe (Google, Machine Learning Crash Course). Nell’articolo originale, il Transformer ottenne risultati migliori nella traduzione dall’inglese al tedesco e dal francese con un costo di addestramento molto inferiore ai modelli precedenti.
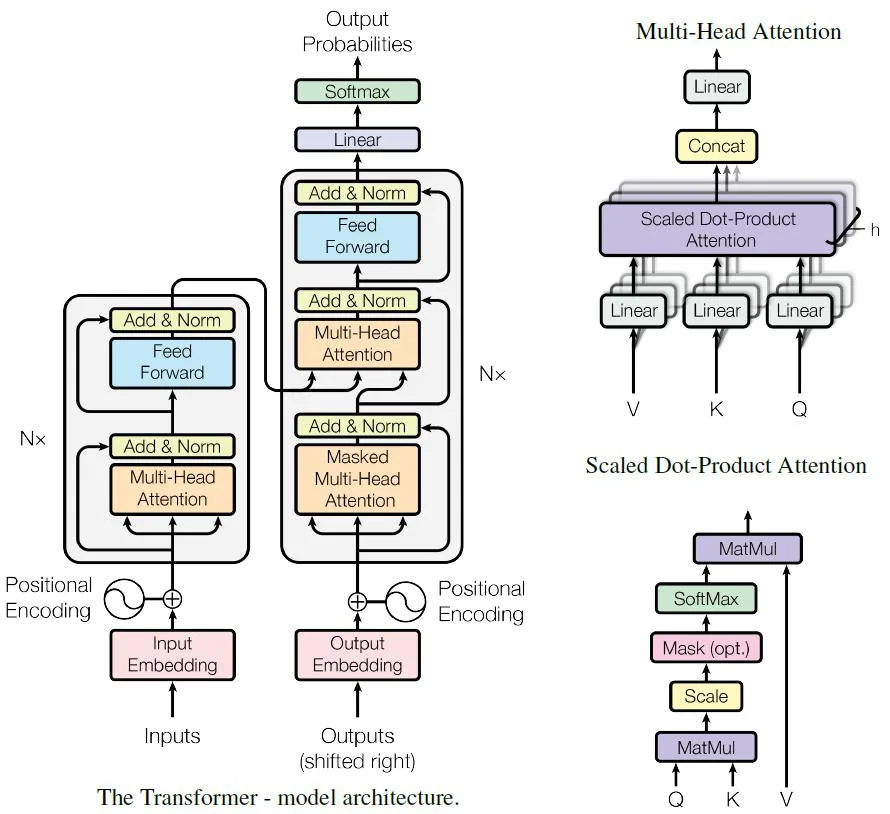
Da qui nasce la differenza tra capire e calcolare. Il modello non ha un archivio di fatti da cui attingere, ha pesi numerici che codificano regolarità del testo su cui è stato addestrato. È il motivo per cui scrive in modo fluente anche quando non c’è nulla di vero da dire, e il motivo per cui la sua risposta cambia se si cambia la formulazione della domanda.
Come si addestra un LLM
L’addestramento procede per fasi, e ogni fase aggiunge una cosa diversa.
- Pre-addestramento. Il modello impara a prevedere il token successivo su grandi quantità di testo, senza che nessuno etichetti i dati: è l’autosupervisione su larga scala, la stessa espressione con cui il regolamento europeo sull’IA descrive i modelli per finalità generali (Regolamento UE 2024/1689, art. 3, punto 63). Da questa fase il modello ricava lingua, stile e una parte enorme di conoscenza sul mondo, insieme ai suoi errori.
- Affinamento supervisionato. Il modello viene ulteriormente addestrato su dimostrazioni scritte da persone, per imparare a rispondere a un’istruzione invece di limitarsi a continuare un testo.
- Feedback umano. Persone classificano diverse risposte del modello e quel giudizio viene usato per orientarlo verso ciò che gli utenti preferiscono, con una tecnica che si chiama apprendimento per rinforzo dal feedback umano (Ouyang et al., Training language models to follow instructions with human feedback).
Le fasi 2 e 3 spiegano un dato che sorprende chi pensa che più grande voglia dire migliore. Nello studio di Ouyang e colleghi (2022), gli utenti preferivano le risposte di un modello da 1,3 miliardi di parametri, addestrato con il feedback umano, a quelle di GPT-3, che ne ha 175 miliardi: cento volte di più. Le dimensioni contano, ma non bastano: conta anche come il modello viene orientato.
Più grande non vuol dire migliore
Dimensioni e preferenze degli utenti, nello studio su InstructGPT.
Parametri (miliardi)
Risposte preferite dai valutatori
Il modello da 1,3 miliardi di parametri, addestrato con feedback umano, è stato preferito a GPT-3, che ha circa cento volte più parametri.
Fonte: Ouyang et al., Training language models to follow instructions with human feedback (2022). La barra del modello più piccolo è in scala.
L’angolo Bliss: perché un’AI dovrebbe consigliare il tuo brand?
Quando un cliente chiede a un assistente AI quale azienda scegliere, la domanda per chi governa il marchio è questa: la risposta restituisce il motivo per cui quel cliente dovrebbe preferirci? Un’impresa può essere citata con il nome giusto, nella categoria giusta, e apparire comunque intercambiabile con i concorrenti. Succede quando la risposta elenca ciò che vende e lascia fuori ciò che la distingue.
Pensiamo a un produttore di macchinari che i clienti scelgono perché riesce a intervenire rapidamente quando una linea si ferma. Se l’assistente lo descrive soltanto come «produttore di macchinari industriali», la descrizione è corretta, ma chi cerca un fornitore capace di ridurre i fermi non trova il motivo per sceglierlo. Una parte del valore del marchio si perde proprio nel momento in cui il cliente confronta le alternative.
Per chi guida l’impresa, il lavoro comincia identificando le ragioni di scelta che contano davvero e verificando dove sono documentate. Nel caso del produttore, possono essere i tempi di intervento pubblicati, la copertura della rete di assistenza o un caso cliente che racconta come è stato gestito un fermo. La generative engine optimization aiuta a verificare se queste informazioni emergono nelle risposte. La prova è fare al modello la stessa domanda che farebbe un cliente e vedere se, accanto al nome del marchio, compare una ragione concreta per sceglierlo.
I limiti di un LLM
I limiti derivano dal funzionamento, e conviene conoscerli prima di affidare al modello un compito.
L’errore più noto è l’allucinazione dell’AI: un testo fluente e plausibile che non corrisponde ai fatti. È un problema riconosciuto da anni, con una letteratura dedicata sulle misure e sui metodi per ridurlo (Ji et al., Survey of Hallucination in Natural Language Generation). Anche i modelli orientati con il feedback umano continuano a fare errori semplici, come riconoscono gli stessi autori dello studio che li ha descritti (Ouyang et al.). Il modello non distingue ciò che sa da ciò che inventa, perché per lui sono lo stesso tipo di operazione.
Il secondo limite sta nei dati. Ciò che il modello produce riflette ciò che ha visto: se un’informazione era assente, scorretta o sbilanciata nel testo di addestramento, la risposta lo sarà. Brown e colleghi segnalano per GPT-3 problemi metodologici legati all’addestramento su grandi raccolte di testo dal web (Brown et al.).
Il terzo riguarda la supervisione: finché il modello può sbagliare senza accorgersene, serve una persona che controlli ciò che produce, come spieghiamo parlando di controllo umano dell’AI.

Cosa si può fare con un LLM
Un LLM è un modello per finalità generali: non è costruito per un compito solo, e può essere integrato in molte applicazioni diverse. Il regolamento europeo lo dice quasi con queste parole, quando definisce il modello di IA per finalità generali come un modello addestrato con grandi quantità di dati, che mostra una generalità significativa e sa svolgere con competenza un’ampia gamma di compiti distinti, integrabile in una varietà di sistemi o applicazioni a valle (Regolamento UE 2024/1689, art. 3, punto 63).
In concreto, lo stesso modello può riassumere un documento, tradurre, classificare messaggi, scrivere una bozza, rispondere a domande su un testo o guidare un agente che esegue una sequenza di azioni. Il risultato dipende da tre cose che si decidono fuori dal modello: le istruzioni, i dati a cui gli si dà accesso e i controlli che si mettono sull’output. È su questi tre punti che un’impresa può intervenire.
LLM e AI Act: che cosa dice il regolamento europeo
Il regolamento europeo sull’IA non usa la sigla LLM come categoria, ma quella di modello di IA per finalità generali (art. 3, punto 63). Ne discendono obblighi specifici per chi li mette sul mercato. Un modello di questo tipo si presume ad alto impatto, con rischio sistemico, quando la quantità cumulativa di calcolo usata per l’addestramento supera 10 elevato alla venticinquesima potenza in operazioni in virgola mobile (art. 51, paragrafo 2); la Commissione può modificare la soglia con atti delegati (art. 51, paragrafo 3).
Dal linguaggio tecnico alle parole del regolamento
Che cosa corrisponde a che cosa nel Regolamento UE 2024/1689.
| Nel linguaggio comune | Nel regolamento | Che cosa prevede |
|---|---|---|
| LLM | Modello di IA per finalità generali (art. 3, punto 63) | Modello addestrato con grandi quantità di dati, con generalità significativa, integrabile in sistemi a valle |
| Modello molto potente | Modello con capacità di impatto elevato (art. 51) | Presunto quando il calcolo cumulativo di addestramento supera 1025 operazioni in virgola mobile |
| Soglia | Modificabile dalla Commissione (art. 51, par. 3) | Atti delegati, alla luce degli sviluppi tecnologici |
Fonte: Regolamento (UE) 2024/1689. Il regolamento non usa la sigla LLM come categoria. Sintesi di Bliss.
Domande frequenti
Cosa significa LLM?
LLM sta per large language model, in italiano modello linguistico di grandi dimensioni. È un modello di intelligenza artificiale addestrato su grandi quantità di testo per prevedere il token successivo di una sequenza, e da questa capacità ricava la possibilità di scrivere, riassumere, tradurre e rispondere a domande.
Che cos’è un modello linguistico?
Un modello linguistico stima la probabilità che un token, o una sequenza di token, compaia in un testo più lungo (Google, Machine Learning Crash Course). Ogni modello di questo tipo, dai più semplici ai più grandi, lavora su questo principio. Un LLM è un modello linguistico molto grande per dati di addestramento e parametri.
ChatGPT è un LLM?
ChatGPT è un’applicazione che permette di dialogare con un modello linguistico: il modello è il motore, l’applicazione è l’interfaccia con cui lo si usa. Nel linguaggio comune i due termini si usano come sinonimi, ma conviene distinguerli quando si valutano rischi, costi e responsabilità.
Come funziona un LLM?
Scompone il testo in token, calcola per ogni token possibile la probabilità di essere il prossimo, ne sceglie uno, lo aggiunge al testo e ripete il ciclo fino a risposta completa. Il calcolo si basa sull’architettura Transformer, che valuta l’intero contesto grazie al meccanismo dell’attenzione (Vaswani et al., 2017).
Come si addestra un LLM?
In più fasi. Prima il pre-addestramento, in cui il modello impara a prevedere il token successivo su grandi quantità di testo. Poi l’affinamento su dimostrazioni scritte da persone e il feedback umano, che orienta le risposte verso ciò che gli utenti preferiscono (Ouyang et al., 2022).
Cosa sono i parametri di un LLM?
Sono i valori numerici che il modello regola durante l’addestramento e che codificano le regolarità apprese dal testo. Il loro numero è la misura più citata delle dimensioni di un modello: GPT-3 ne aveva 175 miliardi (Brown et al., 2020). Più parametri non significano però automaticamente risposte migliori.
Come posso creare un mio LLM?
Addestrare un modello da zero richiede enormi quantità di dati e di calcolo, e per i modelli più grandi il regolamento europeo fissa una soglia di calcolo oltre la quale si presume un rischio sistemico (art. 51). Nella pratica si parte di norma da un modello esistente e lo si adatta con tecniche di tuning (Google, Machine Learning Crash Course).
Cos’è un agente LLM?
È un software che interpreta una richiesta, in testo o a voce, e agisce per eseguirla, con un LLM come componente che capisce l’istruzione e decide il passo successivo. La differenza con un assistente è che l’agente compie azioni, oltre a produrre risposte, e per questo richiede più controlli.
Cosa si può fare con un LLM?
Riassumere e tradurre documenti, classificare messaggi, scrivere bozze, rispondere a domande su un testo, guidare un agente. È un modello per finalità generali, quindi l’uso dipende da istruzioni, dati e controlli scelti da chi lo integra. Su ogni compito conviene verificare l’esito prima di affidarsi al risultato.
Cosa significa LLM in giurisprudenza?
In ambito giuridico LL.M. è la sigla di Legum Magister, un titolo di master in diritto, come quello offerto dalla Facoltà di Giurisprudenza di Heidelberg (Università di Heidelberg, Law – Legum Magister). Con i modelli linguistici condivide solo la sigla, e il contesto della frase basta di solito a distinguere i due significati.
Fonti e riferimenti
- Ashish Vaswani et al., Attention Is All You Need, 2017
- Tom B. Brown et al., Language Models are Few-Shot Learners, 2020
- Long Ouyang et al., Training language models to follow instructions with human feedback, 2022
- Ziwei Ji et al., Survey of Hallucination in Natural Language Generation, ACM Computing Surveys, 2022
- Google, Machine Learning Crash Course, modulo Large language models
- Regolamento (UE) 2024/1689 (AI Act), art. 3, punto 63, e art. 51
- Università di Heidelberg, Law – Legum Magister
- Bliss, Cos’è un AI agent e perché è essenziale per le PMI
- Bliss, Allucinazioni AI: guida per proteggere il brand
- Bliss, GEO: cos’è la Generative Engine Optimization
- Bliss, L’AI è una scatola nera
- Bliss, AI Policy aziendale
- Bliss, Human oversight: il controllo umano dell’AI